所有费用都包含在所有套餐中
并非所有本地化服务都相同。套餐之间的区别仅在于通话时长——以下所有功能在所有套餐中均可使用。
本土化
完全人工智能本地化
只需上传一次,代理即可完成整个流程。
人声与背景分离
将音频分成清晰的对话音轨和单独的音乐/音效音轨,这样原声配乐就能在配音中保留下来。
语音转文字
完整的句子,带有标点符号,可用于添加字幕和隐藏式字幕——支持 80 种源语言,涵盖 154 个区域变体。
创译
这不仅仅是翻译——每一行都根据上下文、语域和原话的长度进行了调整,使其与源音频逐句匹配。
短语时值
停顿和语速与原声表演的节奏相匹配。
声音匹配
既保留了说话者原有的语音特色,又能用目标语言表达出地道的母语口语。
情绪基调
将每句话的情感表达传递到目标语言中。
性别检测
我们自己的模型可以检测每个片段中每个说话者的语音性别,从而自动选择合适的语音,而不是猜测。
通过表演进行匹配
每一句台词都与说话者当时的嗓音完全吻合。说话者低声细语或使用假声时,声音都会按照他们实际的声音进行还原——而不是像其他视频那样,用一种扁平化的声音贯穿整个视频。
字幕
自动生成源语言和目标语言的字幕。
多种目标语言
将单个上传文件本地化为所需的任意多种语言——80 种语言共 154 个目标语言环境,包含 2,782 种语音。
编辑
人工智能为你服务,而不是反过来。
Addavox生成的所有内容都是一个起点,您可以对其进行更改。
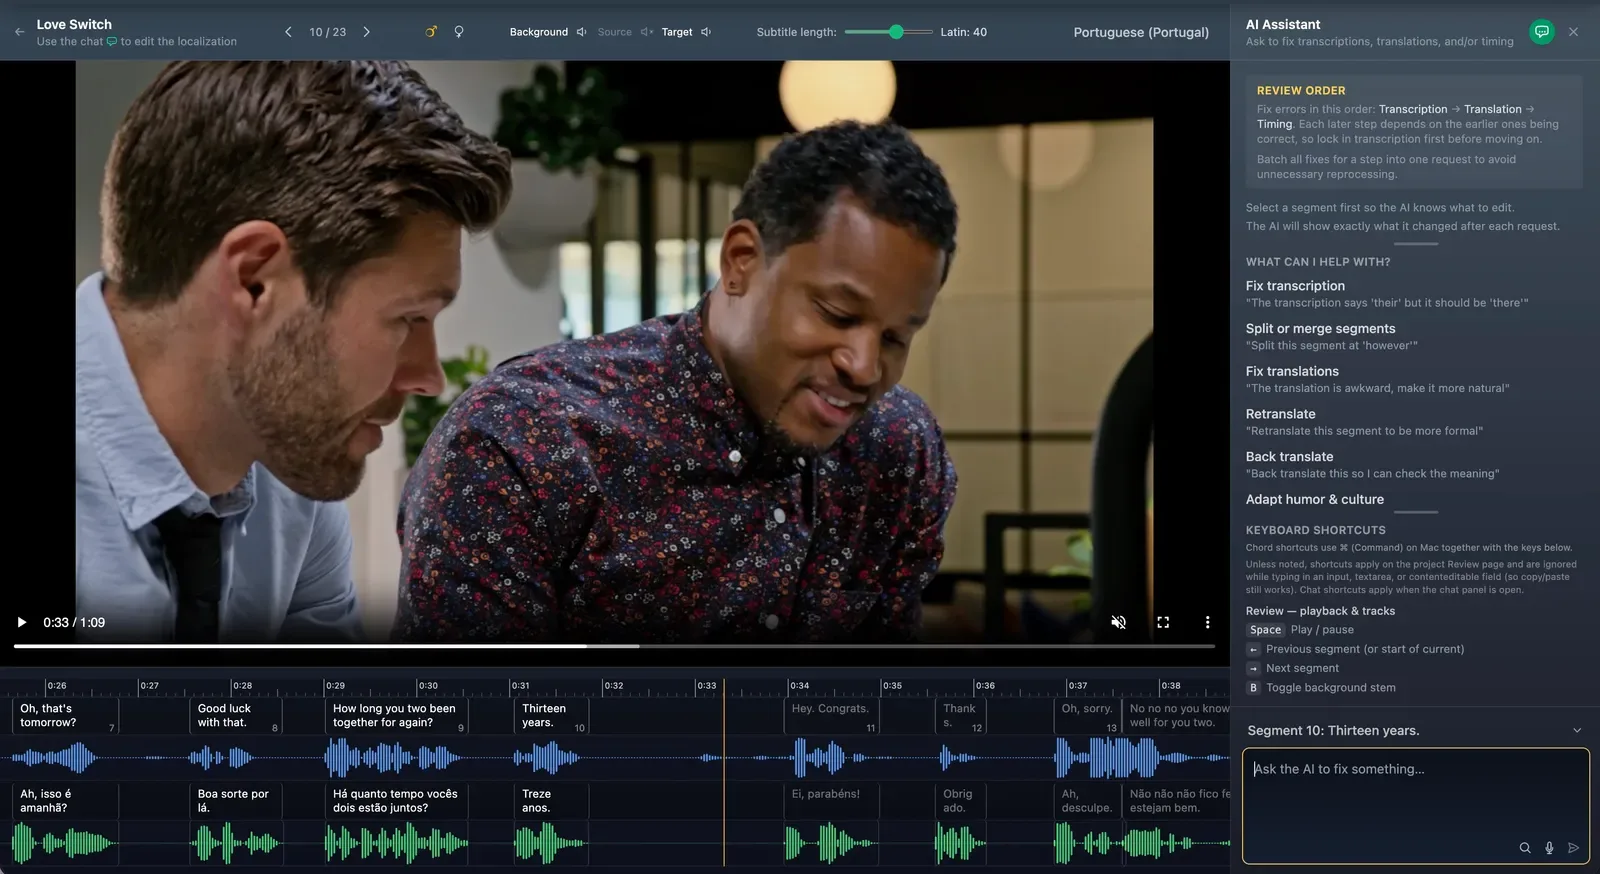
分别聆听每一层的声音。
三轨混音器可将背景音乐、原声和配音分别独立控制。您可以单独控制其中任何一个,也可以平衡控制三个音轨。
任意线条
每个声部都有自己的均衡器、增益和声像。调整其中一条声部,不要影响其他声部,然后将此处理复制到整个项目中。
手动重新计时
拖动波形即可移动它。拉动边缘即可修剪它。在播放头处分割一行。拖动即可重新转录一段文字。
与其追问,不如直接询问。
告诉助手你的需求。“把这个笑话改成法语版,让它更符合法国文化。”“这段太长了,缩短一下。”“把这个词在所有地方都改名。”所有项目范围内的更改都会先预览,供你确认后再应用。
检查含义
将任何一行文字反向翻译,看看它在你母语中的实际含义。无需从头开始重新翻译,即可对其进行更短或更长的改写。
指导演出
在浏览器中自行录制目标语言朗读,然后用原说话者的声音重新配音。最多可混合四个参考片段,以获得更稳定的匹配效果。
匹配的字幕
设置源文件或目标文件的每行字符数。您预览的内容即为导出的SRT和VTT文件的内容。
按照你喜欢的方式工作
编辑器旁边详细标注了所有键盘快捷键和触控手势。它在平板电脑上也确实非常易用。
一个完整的本地化编辑器
- 并排编辑转录和翻译
- 一键合并和拆分片段
- 调整时长——移动、压缩、扩展和修剪音频以适应源文件。
- 添加和编辑片段之间的停顿
- 为任何片段重新生成语音匹配的音频
- 规范说话者的表达方式,使情绪基调更加均衡
- 直接找配音演员:在编辑器中录制目标语言的表演,然后用原说话者的匹配声音重新配音。
- 混合最多四个参考片段以获得更稳定的声音匹配
- 根据时间需要缩短或修改句子,无需重新翻译。
- 将任何一行翻译回您的母语,以检查其含义。
- 完整的音频混音器——每个语音都配有3段均衡器、高通滤波器、增益、声像和旁通开关。
- 编辑器旁边内置了所有键盘快捷键和触摸手势的参考说明。
人工智能代理
人工智能定位代理
用简洁明了的语言提出修改要求,而不是在菜单中查找。
- 通过描述问题来修正转录或翻译。
- 用更正式或更随意的语气重新翻译
- 改编笑话或习语,使其符合文化语境。
- 缩短超出源时间范围的线路
- 正确的性别和代词选择
- 根据内容跳转到任何部分
- 对项目进行全局更改——例如,重命名所有术语、重新设置一批代码片段的样式——所有更改应用前都会进行预览,供您确认。
合作
无需支付前期费用即可聘请母语人士
无需账号。无需许可证。无需入职培训电话。
通过电子邮件邀请
审稿人会收到一个链接,而不是一个账号。他们打开链接即可开始审稿。
仅限一种语言
受邀审稿的法语审稿人只能看到法语内容。这一限制由我们的服务器强制执行,而非隐藏在界面中——因此,审稿人无法访问他们未被邀请审稿的语言。
同时工作
多位审阅者可以同时参与同一个项目。您可以实时查看哪些审阅者在线以及他们正在进行的工作。
变更立即生效
当审校人员修改某一行文本时,该行文本的音频会自动重新生成。无需重新运行,也无需重新导出。
你始终掌控着一切。
链接有效期为七天,可立即撤销。每次更改都会记录更改者、更改内容以及更改后的内容。
嗓音
2782种声音。或者你已经拥有的声音。
保留听众熟悉的演讲者,用他们不熟悉的语言进行演讲。
他们的声音,在154个地方
将说话者的语音特征传递到154目标区域,并支持80种语言。没有最短时长限制: Addavox可以匹配单个单词的语音,而 3-5 秒或更长的语音片段质量会更高。
一刻不停地匹配
人们说话并非只有一种音域。他们会低声耳语,突然切换到假声,或者身体前倾。__ Addavox将每个片段与说话者当时的实际声音相匹配,而不是将它们平均化为整个视频中的单一声音。
情绪承载
每句话的情感表达都会传递到目标语言中,而不仅仅是文字本身。
或者从产品目录中挑选
2,782 种预设语音,供您在不需要(或未获得)原说话人语音时使用。
需要时更稳定
最多可混合四个额外的参考片段,以构建更一致的匹配,从而更准确地匹配难以处理的线条。
自己执导
在编辑器中录制目标语言的发音,然后用原说话者匹配的声音重新配音。
声音匹配,而非声音克隆
大多数人工智能语音技术都会克隆人声。__ Addavox指令集可以匹配人声。这种差异对于视频中所有声音的发出者都至关重要。
语音克隆
已保存的语音副本
大多数语音克隆技术会保存当事人的声音,并以此创建一个克隆体。然后,这个克隆体可以在录音结束后很久的任何时间朗读任何文本。
Addavox声音匹配
逐句演绎,宛如母语人士的表演
Addavox逐句捕捉说话者的语气、音质和情感,并将其存储在记忆中,从而创建一个目标语言的新声音,使其听起来像该语言的母语人士的声音。它不会存储任何声纹、语音模型或克隆语音。
这使得Addavox从设计上就不适合用于深度伪造。我们的重点是为目标受众提供原生体验。
相信
专为本地化而设计,而非用于冒充他人。
语音人工智能通过拒绝做什么来赢得信任。
声音无法用它自己的语言重新生成
Addavox将声音转换成说话者所不使用语言的语言。它不会用说话者的母语重新生成该声音。正是这一限制使得这项技术适用于配音,而无法用于模仿。
同意是一道关卡,而不是一个复选框。
语音匹配本地化必须由某人出具证明,确认已获得说话人的同意并拥有相关内容的版权,方可开始。该证明需带有时间戳,必须为最新证明,并会随项目一起记录。标准的合成语音本地化则完全不处理说话人的声音,也无需获得任何同意。
语音数据绝不会被存储
声音匹配在作业运行期间于内存中逐句进行。之后不会保留任何声纹、声音模型或克隆声音,因此您的项目背后不会积累任何声音库。您项目自身的媒体(您上传的视频以及Addavox生成的本地化音频)会一直保留在项目中,直到您将其删除。
无法完成任务时自动退款
任务失败、文件超出限制、取消订单:所有款项都会自动退还。您无需为未收到的服务付费,也无需提出任何要求。
每一次变化都是可归因的
每一次修改,无论是你自己的还是审阅者的,都会记录下是谁做的修改、修改前的样子以及修改后的样子。
评论者只能看到他们的语言
此限制已在我们的服务器上强制执行。链接有效期为七天,可立即撤销。