Wszystko jest wliczone w cenę każdego planu
Nie wszystkie lokalizacje są sobie równe. Plany różnią się jedynie liczbą minut — każda z poniższych opcji jest dostępna we wszystkich.
Lokalizacja
Pełna lokalizacja AI
Prześlij plik raz, a agent zajmie się nim od początku do końca.
Separacja głosu i tła
Dzieli ścieżkę audio na czyste dialogi i osobną ścieżkę muzyki/efektów, dzięki czemu oryginalna ścieżka dźwiękowa przetrwa dubbing.
Mowa na tekst
Pełne zdania ze znakami interpunkcyjnymi, gotowe do wyświetlenia napisów — w 80 językach źródłowych w 154 wariantach regionalnych.
Transkreacja
Więcej niż tłumaczenie — każdy wers jest dostosowywany do kontekstu, rejestru i długości oryginalnego przekazu, dzięki czemu pasuje do każdej wypowiedzi źródłowej.
Czas trwania frazy
Pauzy i tempo przekazu dostosowane do czasu wykonania źródłowego.
Dopasowanie głosu
Zachowuje charakter głosu mówiącego, brzmiąc jednocześnie jak rodzimy użytkownik języka docelowego.
Ton emocjonalny
Przenosi emocjonalny przekaz każdej wypowiedzi do języka docelowego.
Wykrywanie płci
Nasz model rozpoznaje płeć głosu każdej osoby mówiącej w każdym segmencie, dzięki czemu odpowiedni głos jest wybierany automatycznie, a nie na podstawie zgadywania.
Dopasowane poprzez wydajność
Każda linijka tekstu jest dopasowana do głosu, jaki brzmiał w danym momencie. Głos osoby mówiącej szeptem lub falsetem jest dopasowany do rzeczywistego brzmienia – a nie spłaszczony do jednego głosu przez cały film.
Napisy na filmie obcojęzycznym
Automatyczne generowanie napisów w języku źródłowym i docelowym.
Wiele języków docelowych
Zlokalizuj pojedyncze przesłanie na dowolną liczbę języków — 154 ustawienia regionalne w 80 językach i 2782 głosach.
Redaktor
Sztuczna inteligencja pracuje dla Ciebie, a nie odwrotnie
Wszystko, co wygeneruje Addavox , jest punktem wyjścia, który możesz zmienić.
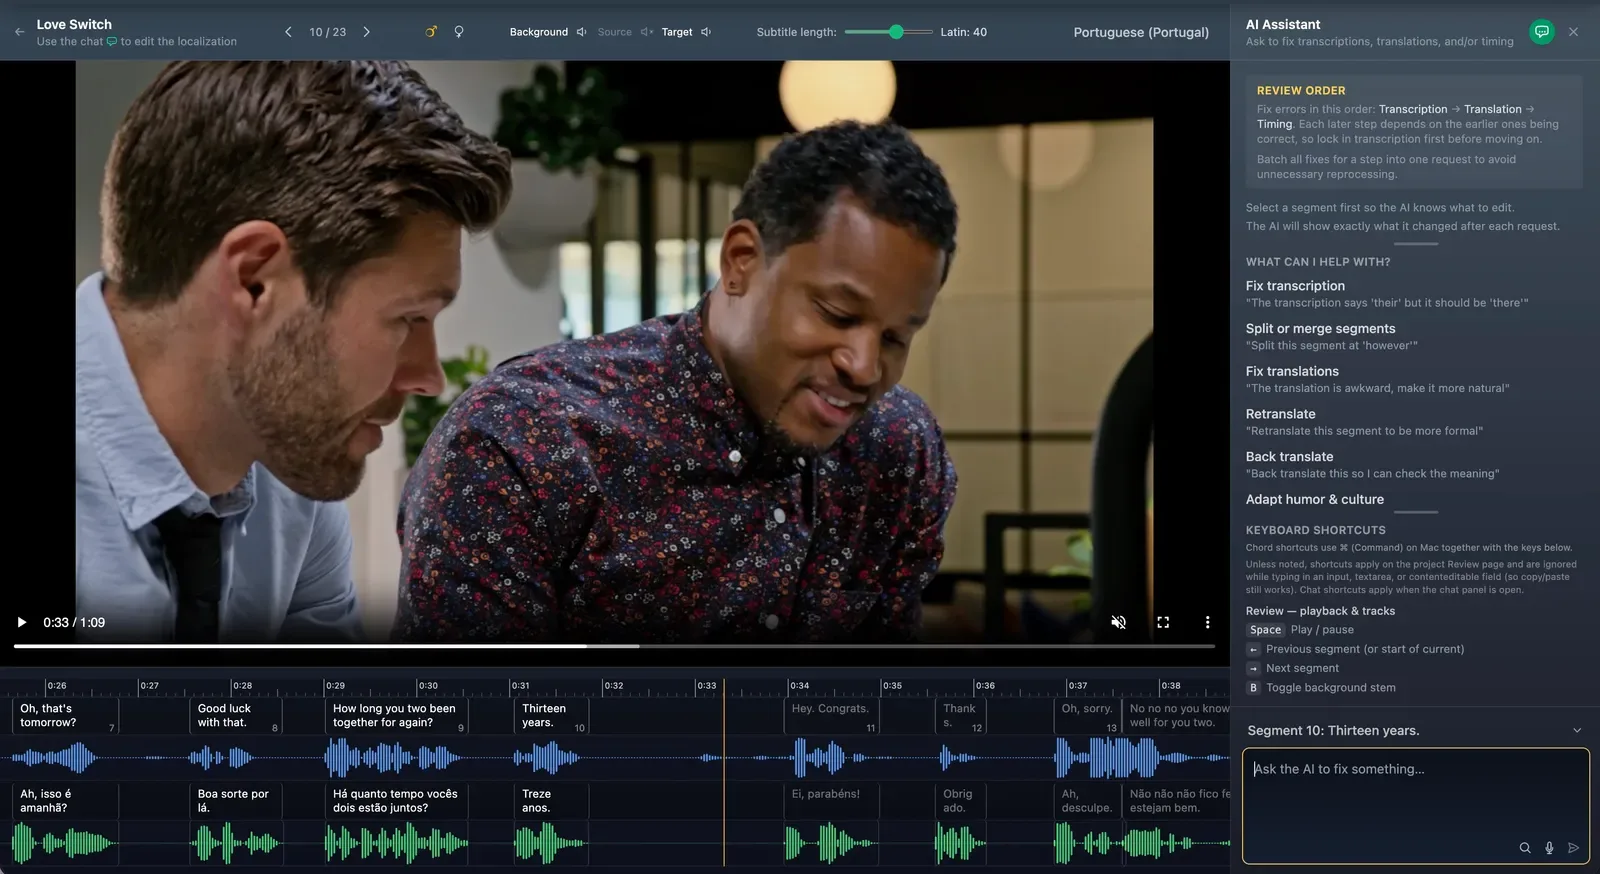
Posłuchaj każdej warstwy osobno
Trzyścieżkowy mikser pozwala na niezależną kontrolę tła, oryginalnego głosu i dubbingu. Możesz solowo ustawić dowolny z nich lub zbalansować wszystkie trzy.
Ukształtuj dowolną linię
Każdy segment ma własny korektor, wzmocnienie i panoramę. Dostosuj jedną linię bez zmiany reszty, a następnie skopiuj tę obróbkę do całego projektu.
Retime ręcznie
Przeciągnij przebieg, aby go przesunąć. Pociągnij krawędź, aby go przyciąć. Podziel linię w punkcie odtwarzania. Ponownie przepisz fragment, przeciągając go.
Pytaj zamiast polować
Powiedz asystentowi, czego chcesz. „Opowiedz ten dowcip jeszcze raz, żeby brzmiał kulturowo po francusku”. „To jest za długie, skróć je”. „Zmień nazwę tego terminu wszędzie”. Zmiany w całym projekcie są podglądane do zatwierdzenia przed ich wprowadzeniem.
Sprawdź znaczenie
Przetłumacz dowolny wers, aby zobaczyć, co tak naprawdę oznacza w Twoim języku. Parafrazuj go krócej lub dłużej bez ponownego tłumaczenia od nowa.
Reżyseruj występ
Nagraj tekst w języku docelowym samodzielnie, w przeglądarce, a następnie zleć jego ponowne odczytanie w dopasowanym głosie oryginalnego mówcy. Połącz maksymalnie cztery segmenty referencyjne, aby uzyskać bardziej spójne dopasowanie.
Napisy, które pasują
Ustaw liczbę znaków w wierszu dla źródła lub celu. To, co podglądasz, to zawartość wyeksportowanych SRT i VTT .
Pracuj tak, jak lubisz
Każdy skrót klawiaturowy i gest dotykowy są udokumentowane obok edytora. Są naprawdę użyteczne na tablecie.
Kompletny edytor lokalizacji
- Edytuj transkrypcję i tłumaczenie obok siebie
- Łącz i dziel segmenty jednym kliknięciem
- Dostosuj synchronizację — przesuń, skompresuj, rozszerz i przytnij dźwięk, aby dopasować go do źródła
- Dodawaj i edytuj pauzy między segmentami
- Regeneruj dźwięk dopasowany do głosu dla dowolnego segmentu
- Znormalizuj sposób przekazu dla mówcy, aby wyrównać ton emocjonalny
- Bezpośredni lektor: nagrywa wykonanie w języku docelowym w edytorze, a następnie ponownie podkłada głos w głosie oryginalnego lektora
- Połącz do czterech segmentów referencyjnych, aby uzyskać stabilniejsze dopasowanie głosu
- Skróć lub rozwiń linię, aby dopasować ją do czasu, bez ponownego tłumaczenia
- Przetłumacz dowolny wiersz, aby sprawdzić jego znaczenie w swoim języku
- Pełny mikser audio — 3-pasmowy korektor, filtr górnoprzepustowy, wzmocnienie, panoramowanie i obejście dla każdej wypowiedzi
- Wbudowane odniesienie do każdego skrótu klawiaturowego i gestu dotykowego, obok edytora
Agent AI
Agent lokalizacji AI
Poproś o zmiany, pisząc prostym językiem, zamiast szukać odpowiedzi w menu.
- Napraw transkrypcję lub tłumaczenie, opisując problem
- Przetłumacz ponownie w bardziej formalnym lub mniej formalnym rejestrze
- Zaadaptuj żart lub idiom tak, aby zagościł w kulturze
- Skróć linię biegnącą poza czas źródłowy
- Prawidłowy wybór rodzaju i zaimka
- Przejdź do dowolnego segmentu, korzystając z tego, co on mówi
- Wprowadzaj zmiany w całym projekcie — zmieniaj nazwy terminów wszędzie, zmieniaj styl partii segmentów — podgląd w celu potwierdzenia przed zastosowaniem jakichkolwiek zmian
Współpraca
Zatrudnij native speakera bez ponoszenia kosztów konfiguracji
Żadnych kont. Żadnych licencji. Żadnych rozmów wprowadzających.
Zaproszenie e-mailem
Recenzent otrzymuje link, a nie konto. Otwiera go i zaczyna pracować.
Zakres ograniczony do jednego języka
Recenzent zaproszony do języka francuskiego widzi język francuski. Ta granica jest egzekwowana na naszych serwerach, a nie ukryta w interfejsie — więc recenzent nie może uzyskać dostępu do języka, do którego nie został zaproszony.
Pracuj w tym samym czasie
Kilku recenzentów może pracować nad jednym projektem jednocześnie. Możesz na bieżąco obserwować, kto jest online i nad czym pracuje.
Zmiany wchodzą w życie natychmiast
Gdy recenzent edytuje wers, dźwięk tego wersu jest automatycznie generowany ponownie. Bez ponownego odtwarzania i ponownego eksportu.
Masz kontrolę
Linki wygasają po siedmiu dniach i można je natychmiast usunąć. Każda zmiana rejestruje, kto ją wprowadził, co to było i czym się stała.
Głos
2782 głosów. Albo ten, który już masz.
Niech mówca, którego publiczność już zna, mówi w języku, którego nie zna.
Ich głos w 154 lokalizacjach
Przenieś charakter głosu mówcy do docelowych ustawień regionalnych 154 w językach 80. Nie ma minimalnej długości: Addavox może dopasować głos do pojedynczego słowa, a jakość poprawia się w przypadku dłuższych wypowiedzi, trwających około 3–5 sekund lub dłużej.
Dopasowane chwila po chwili
Ludzie nie mówią w jednym rejestrze. Zniżają głos do szeptu, przeskakują do falsetu, ustawiają się w szeregu. Addavox dopasowuje każdy fragment do tego, jak mówca brzmiał w danym momencie, zamiast uśredniać je do jednego głosu dla całego filmu.
Emocje niosą
Emocjonalny przekaz każdego wersu jest słyszalny w języku docelowym, nie tylko same słowa.
Lub wybierz z katalogu
2782 wstępnie ustawionych głosów na wypadek, gdybyś nie potrzebował głosu oryginalnego mówcy lub nie wyraził na to zgody.
Bardziej stabilny, kiedy tego chcesz
Połącz maksymalnie cztery dodatkowe segmenty odniesienia, aby uzyskać bardziej spójne dopasowanie w przypadku trudnej linii.
Reżyseruj sam
Nagraj wykonanie w języku docelowym w edytorze, a następnie przerób je na głos oryginalnego mówcy.
Dopasowanie głosu, a nie klonowanie głosu
Większość technologii głosowych opartych na sztucznej inteligencji klonuje głosy. Addavox je dopasowuje. Różnica ma znaczenie dla każdego, kogo głos pojawia się w filmie.
Klonowanie głosu
Zapisana kopia głosu
Większość technologii klonowania głosu zapisuje głos danej osoby i tworzy na jego podstawie klon. Klon może następnie wypowiedzieć dowolny tekst, w dowolnym momencie, długo po zakończeniu sesji nagraniowej.
Dopasowanie głosu Addavox
Natywny występ, zdanie po zdaniu
Addavox rejestruje w pamięci ton głosu, cechy wokalne i emocje mówiącego, zdanie po zdaniu, i tworzy nowy głos w języku docelowym, który brzmi jak jego ojczysty odpowiednik. Nie są przechowywane żadne odciski głosu, modele głosu ani klonowane głosy.
To sprawia, że Addavox jest kiepskim narzędziem do tworzenia deepfake'ów, i to z założenia. Skupiamy się na stworzeniu natywnego doświadczenia dla grupy docelowej.
Zaufanie
Stworzone z myślą o lokalizacji. Nie po to, by podszywać się pod kogoś.
Sztuczna inteligencja głosowa zdobywa zaufanie poprzez to, czego odmawia zrobienia.
Głosu nie można odtworzyć w jego własnym języku
Addavox przenosi głos do języka, którego nie używa mówca. Nie odtworzy tego głosu w języku ojczystym. To właśnie to ograniczenie sprawia, że technologia ta jest przydatna do dubbingu, ale nie nadaje się do naśladowania.
Zgoda to brama, a nie pole wyboru
Lokalizacja z dopasowaniem głosu nie może się rozpocząć, dopóki ktoś nie potwierdzi imiennie, że posiada zgodę mówiącego i prawa do treści. To potwierdzenie jest opatrzone znacznikiem czasu, musi być aktualne i zarejestrowane w projekcie. Standardowa lokalizacja z wykorzystaniem głosu syntetycznego nie przetwarza w ogóle głosu mówiącego i nie wymaga jego zgody.
Dane głosowe nigdy nie są przechowywane
Dopasowanie głosu odbywa się w pamięci, zdanie po zdaniu, w trakcie wykonywania zadania. Potem nie jest przechowywany żaden odcisk głosu, model głosu ani sklonowany głos, więc za Twoimi projektami nie narasta żadna biblioteka głosów. Własne multimedia projektu — przesłane przez Ciebie wideo i zlokalizowany dźwięk wygenerowany przez Addavox — pozostają w projekcie, dopóki ich nie usuniesz.
Automatyczne zwroty kosztów w przypadku niemożności dostarczenia zlecenia
Nieudane zlecenie, przekroczenie limitu pliku, anulowanie: za każde z nich otrzymasz automatyczny zwrot pieniędzy. Nigdy nie zostaniesz obciążony opłatą za pracę, której nie otrzymałeś, i nie musisz o nią prosić.
Każda zmiana jest przypisywalna
Każda edycja, Twoja lub recenzenta, dokumentuje, kto ją wykonał, czym była wcześniej i czym się stała.
Recenzenci widzą tylko swój język
Obowiązuje na naszych serwerach. Linki wygasają po siedmiu dniach i mogą zostać natychmiastowo usunięte.