所有費用都包含在所有套餐中
並非所有本地化服務都相同。套餐之間的差異僅在於通話時長——以下所有功能在所有套餐中均可使用。
本土化
完全人工智慧本地化
只需上傳一次,代理即可完成整個流程。
人聲與背景分離
將音訊分成清晰的對話音軌和單獨的音樂/音效音軌,這樣原聲配樂就能在配音中保留下來。
語音轉文字
完整的句子,帶有標點符號,可用於添加字幕和隱藏式字幕——支援 80 種來源語言,涵蓋 154 個區域變體。
創譯
這不僅僅是翻譯——每一行都根據上下文、語域和原話的長度進行了調整,使其與來源音訊逐句匹配。
短語時值
停頓和語速與原聲表演的節奏相匹配。
聲音匹配
既保留了說話者原有的語音特色,又能用目標語言表達出道地的母語口語。
情緒基調
將每句話的情感表達傳遞到目標語言。
性別檢測
我們自己的模型可以偵測每個片段中每個說話者的語音性別,從而自動選擇合適的語音,而不是猜測。
透過表演進行配對
每一句台詞都與說話者當時的嗓音完全吻合。當說話者低聲細語或使用假聲時,聲音都會按照他們實際的聲音進行還原——而不是像其他視頻那樣,用一種扁平化的聲音貫穿整個視頻。
字幕
自動產生來源語言和目標語言的字幕。
多種目標語言
將單一上傳檔案在地化為所需的任意多種語言——80 種語言共 154 個目標語言環境,包含 2,782 種語音。
編輯
人工智慧為你服務,而不是反過來。
Addavox產生的所有內容都是一個起點,您可以對其進行更改。
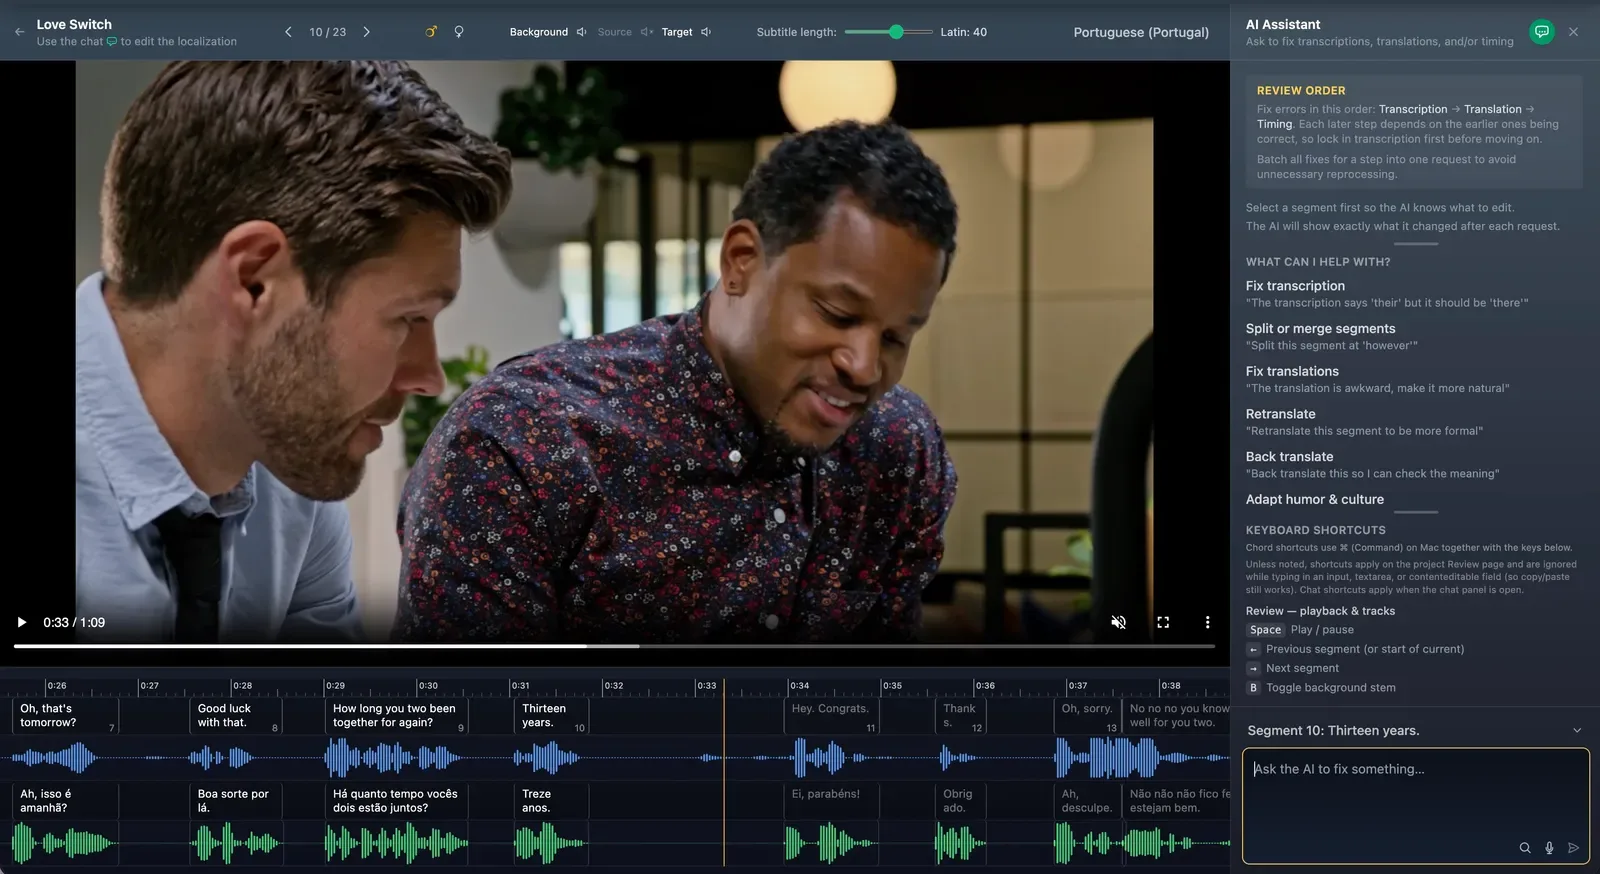
分別聆聽每一層的聲音。
三軌混音器可將背景音樂、原聲和配音分別獨立控制。您可以單獨控制其中任何一個,也可以平衡控制三個音軌。
任意線條
每個聲部都有自己的均衡器、增益和聲像。調整其中一條聲部,不要影響其他聲部,然後將此處理複製到整個專案中。
手動重新計時
拖曳波形即可移動它。拉動邊緣即可修剪它。在播放頭分割一行。拖曳即可重新轉錄一段文字。
與其追問,不如直接詢問。
告訴助手你的需求。 「把這個笑話改成法語版,讓它更符合法國文化。」「這段太長了,縮短一下。」「把這個詞在所有地方都改名。」所有項目範圍內的更改都會先預覽,供你確認後再應用。
檢查意義
將任何一行文字反向翻譯,看看它在你母語中的實際意義。無需從頭開始重新翻譯,即可對其進行更短或更長的改寫。
指導演出
在瀏覽器中自行錄製目標語言朗讀,然後用原說話者的聲音重新配音。最多可混合四個參考片段,以獲得更穩定的配對效果。
匹配的字幕
設定來源檔案或目標檔案的每行字元數。您預覽的內容即為匯出的SRT和VTT檔案的內容。
按照你喜歡的方式工作
編輯器旁邊詳細標註了所有鍵盤快捷鍵和觸控手勢。它在平板電腦上也確實非常容易使用。
一個完整的本地化編輯器
- 並排編輯轉錄和翻譯
- 一鍵合併和分割片段
- 調整時長-移動、壓縮、擴展和修剪音訊以適應原始檔案。
- 新增和編輯片段之間的停頓
- 為任何片段重新產生語音匹配的音頻
- 規範說話者的表達方式,使情緒基調更均衡
- 直接找配音員:在編輯器中錄製目標語言的表演,然後用原說話者的配對聲音重新配音。
- 混合最多四個參考片段以獲得更穩定的聲音匹配
- 根據時間需要縮短或修改句子,無需重新翻譯。
- 將任何一行翻譯回您的母語,以檢查其含義。
- 完整的音訊混音器-每個語音都配有3段均衡器、高通濾波器、增益、聲像和旁通開關。
- 編輯器旁邊內建了所有鍵盤快捷鍵和觸控手勢的參考說明。
人工智慧代理
人工智慧定位代理
用簡潔明了的語言提出修改要求,而不是在選單中尋找。
- 透過描述問題來修正轉錄或翻譯。
- 用更正式或更隨興的語氣重新翻譯
- 改編笑話或習慣用語,使其符合文化脈絡。
- 縮短超出來源時間範圍的線路
- 正確的性別和代名詞選擇
- 根據內容跳到任何部分
- 對專案進行全域變更-例如,重新命名所有術語、重新設定一批程式碼片段的樣式-所有變更應用程式前都會進行預覽,供您確認。
合作
無需支付前期費用即可聘請母語人士
無需帳號。無需許可證。無需入職訓練電話。
透過電子郵件邀請
審稿人會收到一個鏈接,而不是一個帳號。他們打開連結即可開始審稿。
僅限一種語言
受邀審稿的法文審稿人只能看到法文內容。這項限制由我們的伺服器強制執行,而非隱藏在介面中——因此,審查者無法存取他們未被邀請審稿的語言。
同時工作
多位審閱者可以同時參與同一個專案。您可以即時查看哪些審閱者在線上以及他們正在進行的工作。
變更立即生效
當審校人員修改某一行文字時,該行文字的音訊會自動重新產生。無需重新運行,也無需重新匯出。
你始終掌控著一切。
連結有效期為七天,可立即撤銷。每次更改都會記錄更改者、更改內容以及更改後的內容。
嗓音
2782種聲音。或是你已經擁有的聲音。
保留聽眾熟悉的演講者,用他們不熟悉的語言進行演講。
他們的聲音,在154個地方
將說話者的語音特徵傳遞到154目標區域,並支援80種語言。沒有最短時長限制: Addavox可以匹配單字的語音,而 3-5 秒或更長的語音片段品質會更高。
一刻不停地匹配
人們說話並非只有一種音域。他們會低聲耳語,突然切換到假聲,或是身體前傾。 __ Addavox將每個片段與說話者當時的實際聲音相匹配,而不是將它們平均化為整個視頻中的單一聲音。
情緒承載
每句話的情感表達都會傳遞到目標語言中,而不僅僅是文字本身。
或從產品目錄中挑選
2,782 種預設語音,供您在不需要(或未獲得)原始說話者語音時使用。
需要時更穩定
最多可混合四個額外的參考片段,以建立更一致的匹配,從而更準確地匹配難以處理的線條。
自己執導
在編輯器中錄製目標語言的發音,然後用原說話者匹配的聲音重新配音。
聲音匹配,而非聲音複製
大多數人工智慧語音技術都會複製人聲。 __ Addavox指令集可以符合人聲。這種差異對於影片中所有聲音的發出者都至關重要。
語音克隆
已儲存的聲音副本
大多數語音複製技術會保存當事人的聲音,並以此創建一個克隆體。然後,這個克隆體可以在錄音結束後很久的任何時間朗讀任何文字。
Addavox聲音匹配
逐句演繹,宛如母語人士的表演
Addavox逐句捕捉說話者的語氣、音質和情感,並將其儲存在記憶中,從而創造一個目標語言的新聲音,使其聽起來像該語言的母語人士的聲音。它不會儲存任何聲紋、語音模型或複製語音。
這使得Addavox從設計上就不適合用於深度偽造。我們的重點是為目標受眾提供原生體驗。
相信
專為本地化而設計,而非用於冒充他人。
語音人工智慧透過拒絕做什麼來贏得信任。
聲音無法用它自己的語言重新生成
Addavox將聲音轉換成說話者所不使用語言的語言。它不會用說話者的母語重新產生該聲音。正是這項限制使得這項技術適用於配音,而無法用於模仿。
同意是一道關卡,而不是一個複選框。
語音配對本地化必須由某人出具證明,確認已獲得說話人的同意並擁有相關內容的版權,方可開始。此證明需帶有時間戳,必須為最新證明,並會隨項目一起記錄。標準的合成語音在地化則完全不處理說話者的聲音,也無需獲得任何同意。
語音資料絕對不會儲存
聲音匹配在作業執行期間於記憶體中逐句進行。之後不會保留任何聲紋、聲音模型或複製聲音,因此不會在您的專案背後累積聲音資料庫。您專案本身的媒體(您上傳的影片以及Addavox產生的在地化音訊)會保留在專案中,直到您將其刪除。
無法完成任務時自動退款
任務失敗、文件超出限制、取消訂單:所有款項都會自動退還。您無需為未收到的服務付費,也無需提出任何要求。
每一次變化都是可歸因的
每一次修改,無論是你自己的還是審閱者的,都會記錄下是誰做的修改、修改前的樣子以及修改後的樣子。
評論者只能看到他們的語言
此限制已在我們的伺服器上強制執行。連結有效期為七天,可立即撤銷。